Llama Factory 微调
1 准备数据集
1.1 选项 1:提取一般数据集
1.1.1 目录结构
prepair_dataset/
├── book
└── saveChunk
1.1.2 安装
git clone https://github.com/pharaohnie/make_dataset
cd make_dataset
virtualenv .env
source .venv/bin/activate
pip install -r requirements.txt
1.1.3 切割文本
编辑 .env
# 需要切割的文本
INPUT_FILE_PATH=./book/zhenhuan.txt

BASE_URL=http://10.0.1.125:30004/v1
API_KEY=sk-xxx
MODEL=Qwen/Qwen2-72B-Instruct-AWQ

# 每个分段中提取问题的数量
ENTRIES_PER_FILE=20
把需要切割的长文本放到 ./book/ 中,这里命名为 zhenhuan.txt
运行 python split.py,切割后的文本后保存到 ./saveChunk/,切割后的分段文本为 2048 个 token。
1.1.4 提取问题
运行 python make_dataset.py,从 ./saveChunk/ 中的 .txt 文件提取问题。
原理是:
基于以下文本,生成1个用于指令数据集的高质量条目。条目应该直接关联到给定的文本内容,提出相关的问题或任务。
请使用{instruction_type}作为提问引导词进行提问。下面是提问方式的举例:
{instruction_type} 包含了:如何看待、分析、比较、解释、评价、为什么 几种提问方式。
运行完成后,会生成 instruction_dataset.parquet,这个文件是可以上传到 huggingface 的。

在实际微调中,只有 instructon 和 output 有用
1.2 选项 2:提取某人对话
1.2.1 目录结构
get_role_dialogue/
├── dataset
└── output
1.2.2 安装
git clone https://github.com/pharaohnie/get_role_dialogue
cd get_role_dialogue
virtualenv .env
source .venv/bin/activate
pip install -r requirements.txt
1.2.3 提取对话
编辑 .env
DEEPSEEK_API_KEY=sk-xxx

# 提取对话的文本,可以是剧本,可以是小说文本等
TEXTFILE=./dataset/zhenhuan.txt

#  要提取对话人物的名字、别名、小名儿
ROLES=皇帝,皇上,四郎
运行 python main.py,会生成 ./output/instruction_dataset.parquet,这个文件也可以上传到 huggingface。
同时还会生成 ./output/zhenhuan.json 和 ./output/zhenhuan.jsonl
!!! zhenhuan.jsonl 并不是标准格式,是一个临时的过程文件
1.3 几种训练集
一共有三种训练集:json、jsonl、parquet
1.3.1 json
[
  {
    "instruction": "",
    "input": "请皇上翻牌子。",
    "output": "哪来那么多话?"
  },
  {
    "instruction": "",
    "input": "皇上,太后来了。",
    "output": "快,请太后进来。"
  }
]
经过几次测试,可以直接使用 json 格式,能够直接放到本地,不需要上传到 huggingface。
1.3.2 jsonl
{"input": "徐进良", "output": "请皇上翻牌子。"}
{"role": "小厦子", "dialogue": "皇上,太后来了。"}
1.3.3 paraquet
Parquet文件是一种列式存储格式,广泛用于大数据处理和分析。它有以下几个显著特点:
- 列式存储:Parquet文件以列为单位进行存储,而不是传统的行式存储。这使得它在处理某些特定列的查询时非常高效,因为只需要读取相关列的数据,而不必读取整个表的数据。
- 压缩效率高:由于数据在列内通常具有相似性,Parquet文件可以对每一列的数据进行高度压缩,从而减少存储空间和I/O操作的成本。常用的压缩算法包括Snappy、Gzip和LZO。
- 灵活性和扩展性:Parquet支持复杂的数据类型,包括嵌套结构(例如,嵌套的结构体和数组)。这使得Parquet能够很好地适应复杂的数据模型,适用于多种数据分析场景。
- 高效的读写性能:由于列式存储和压缩的特性,Parquet文件在读写性能上表现出色,特别是在处理大规模数据集时。对于只需要访问部分列的查询,Parquet可以显著减少I/O操作,从而提升查询速度。
- 跨平台支持:Parquet文件格式是由Apache开源的,并且得到了多个大数据处理平台的广泛支持,例如Apache Hadoop、Apache Spark、Apache Drill等。因此,Parquet文件可以在不同平台之间无缝传输和使用。
- 自描述文件格式:Parquet文件中包含了元数据,描述了文件的结构和存储模式,这使得文件在没有额外描述的情况下也能够被正确解读。这些元数据通常包括列的名称、类型、压缩方式等信息。
- 类型丰富:Parquet支持多种数据类型,包含基本数据类型(如整数、浮点数、布尔值等)和复杂数据类型(如数组、结构体等),这使得它在处理各种数据格式时具有很强的适应性。
2 安装 llama factory
git clone --depth 1 https://github.com/hiyouga/LLaMA-Factory.git
cd LLaMA-Factory
virtualenv .venv
source .venv/bin/activate
pip install -e ".[torch,metrics,bitsandbytes,awq,vllm,qwen,modelscope]"
pip install oss2 addict
3 设置 llama factory 的数据集
以训练某人说话风格为例,把 huangdi.json 放到 LLaMA-Factory/data
[
  {
    "system": "用四郎的口吻回答问题",
    "input": "皇上,您这半个月都没进后宫了,要是今天再不翻牌子,那太后一定会怪罪奴才的。",
    "output": "哪来那么多话?",
    "instruction": ""
  }
]
编辑 LLaMA-Factory/data/dataset_info.json,加入
[
  "huangdi": {
    "file_name": "huangdi.json",
    "columns": {
      "prompt": "instruction",
      "query": "input",
      "response": "output",
      "system": "system"
    }
  },
]
这里的 columns 是和 huangdi.json 中的键对应的。
4 开始微调
运行 run.sh
#!/bin/bash

export OMP_NUM_THREADS=1
export CUDA_VISIBLE_DEVICES=0
#export CUDA_VISIBLE_DEVICES=0,1,2
export CUTLASS_PATH=/home/cutlass

如果想从 modelscope下载模型,取销这行注释
#export USE_MODELSCOPE_HUB=1

cd /home/LLaMA-Factory
source .venv/bin/activate
llamafactory-cli webui

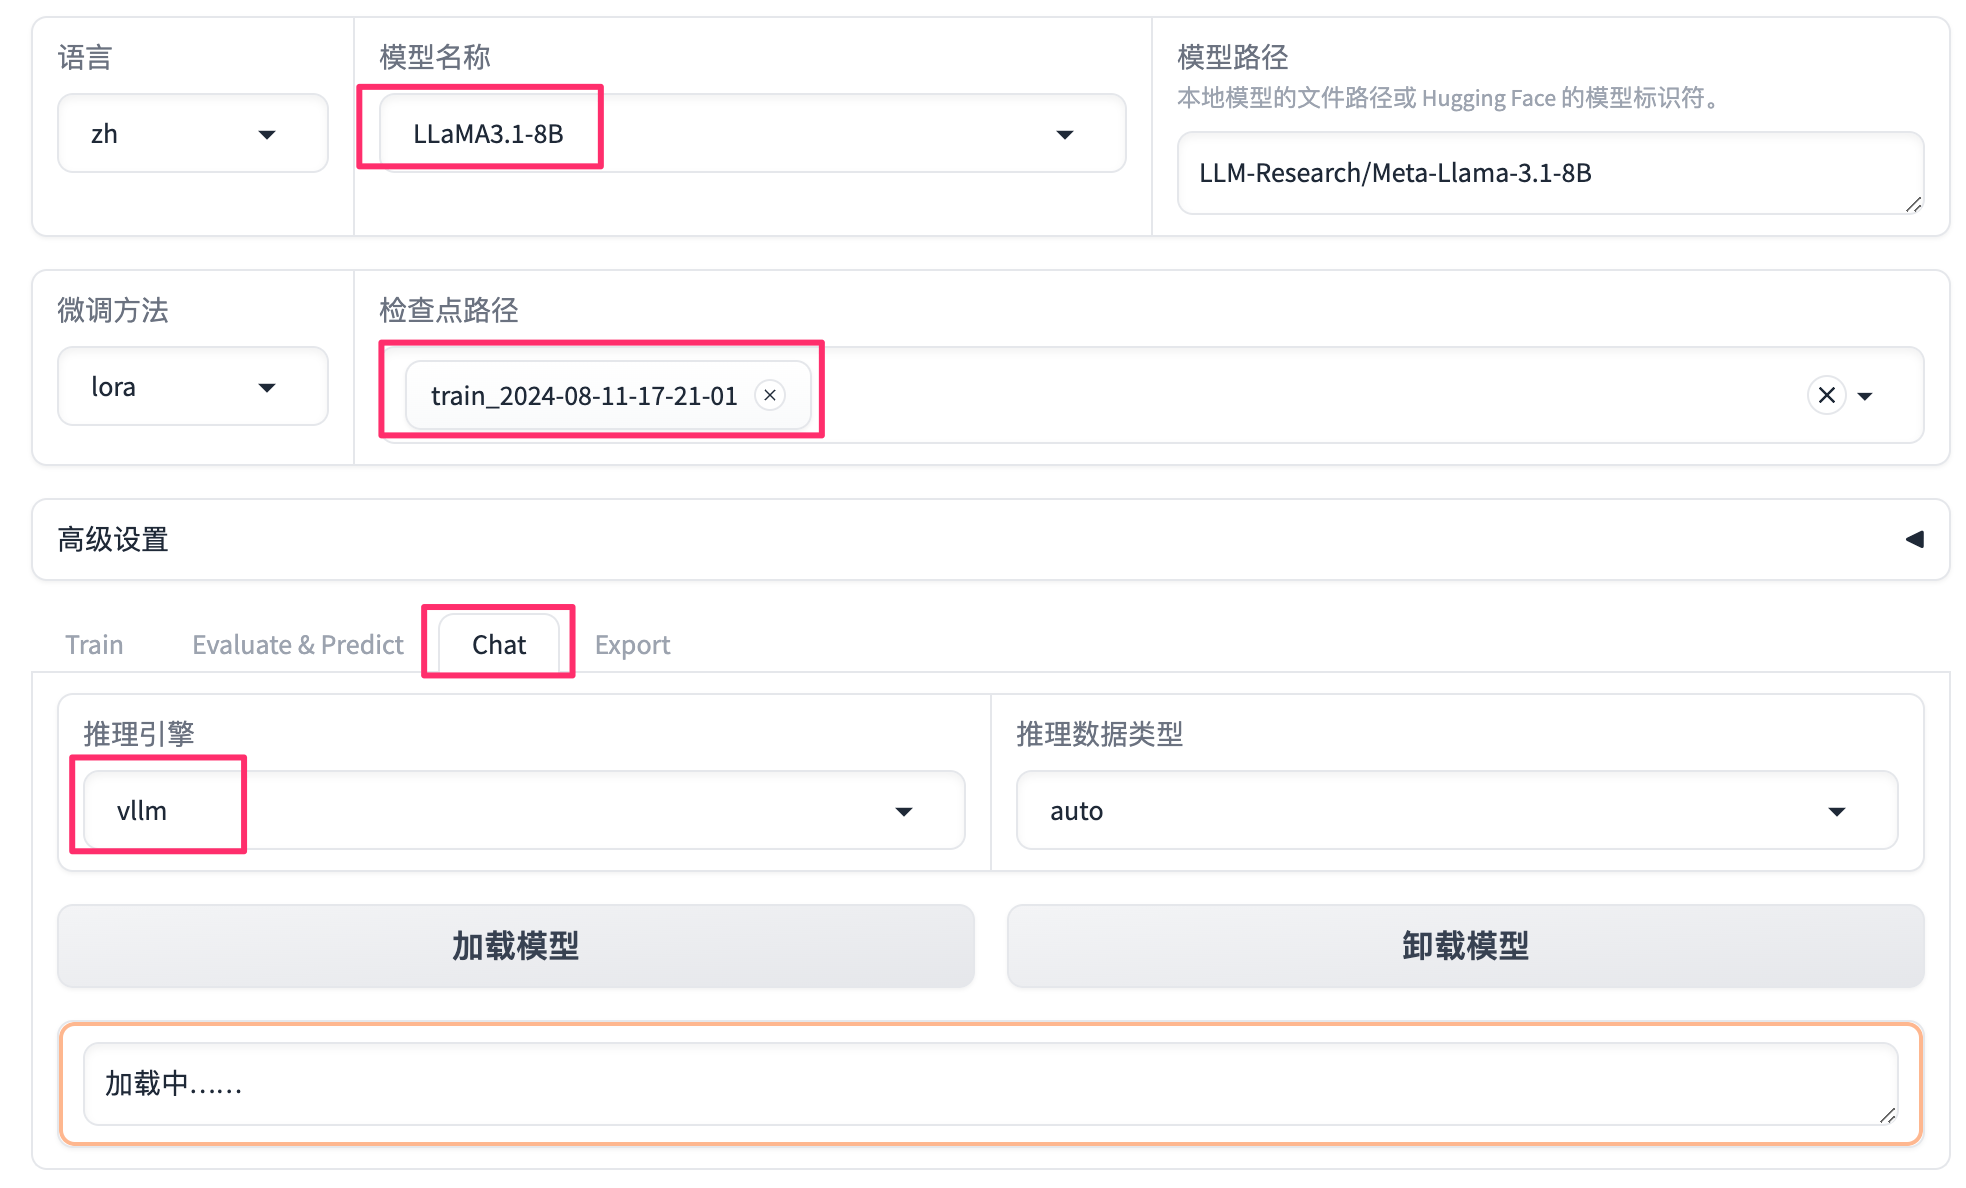
选择模型和方法
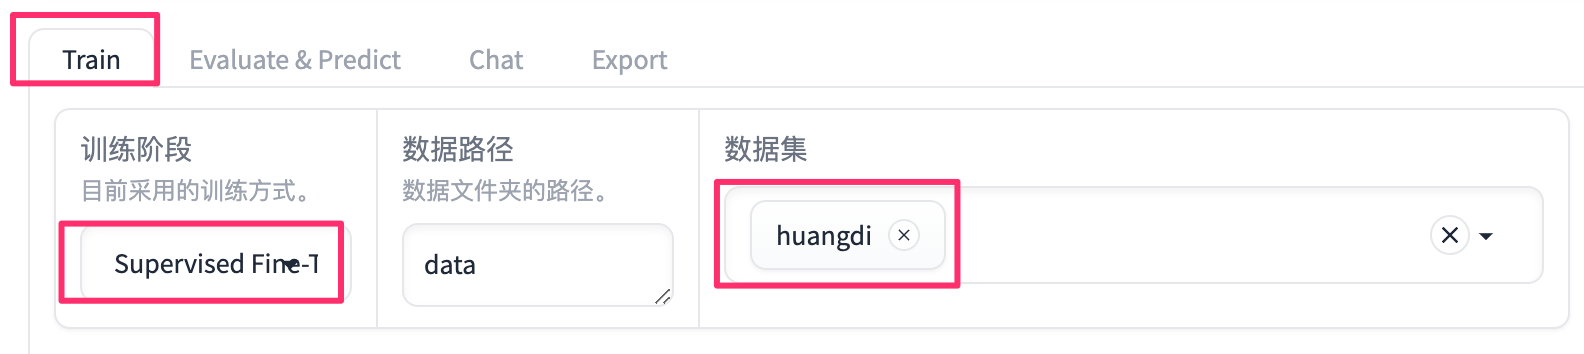
选择训练、SFT 和数据集。
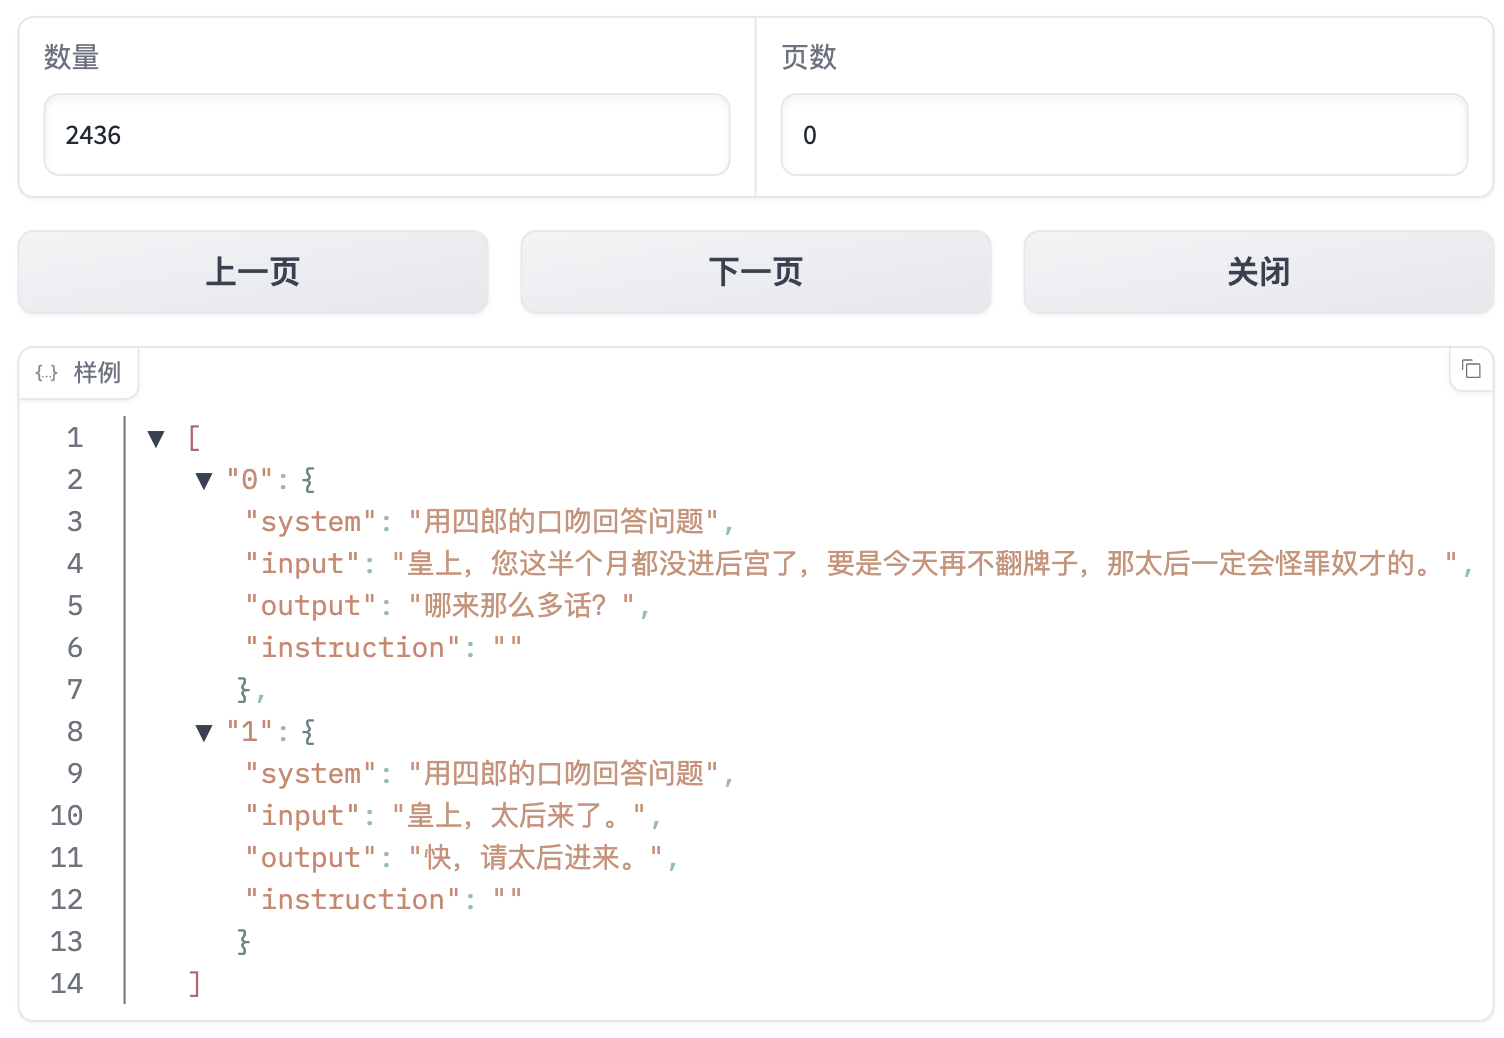
预览数据集

设置学习率、轮数、批处理大小。
点击 开始 后,可以在 console 界面看到
input_ids:
[11883, 64803, 104703, 9554, 40526, 7305, 119, 113925, 87219, 198, 35075, 25, 220, 105600, 17905, 125653, 44388, 103268, 19483, 9953, 72368, 72027, 42399, 34547, 112880, 35287, 114985, 21043, 110916, 88356, 16937, 111602, 104241, 45829, 106169, 101402, 34547, 111419, 38093, 107297, 108789, 117694, 102280, 9554, 9174, 72803, 25, 106189, 37507, 111498, 43240, 58543, 11571, 128001]
inputs:
用四郎的口吻回答问题
Human: 皇上,您这半个月都没进后宫了,要是今天再不翻牌子,那太后一定会怪罪奴才的。
Assistant:哪来那么多话?<|end_of_text|>
label_ids:
[-100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, -100, 106189, 37507, 111498, 43240, 58543, 11571, 128001]
labels:
哪来那么多话?<|end_of_text|>
这里就知道 llama factory 中 inputs、Human、Assistant 对应数据集的都是什么内容了。
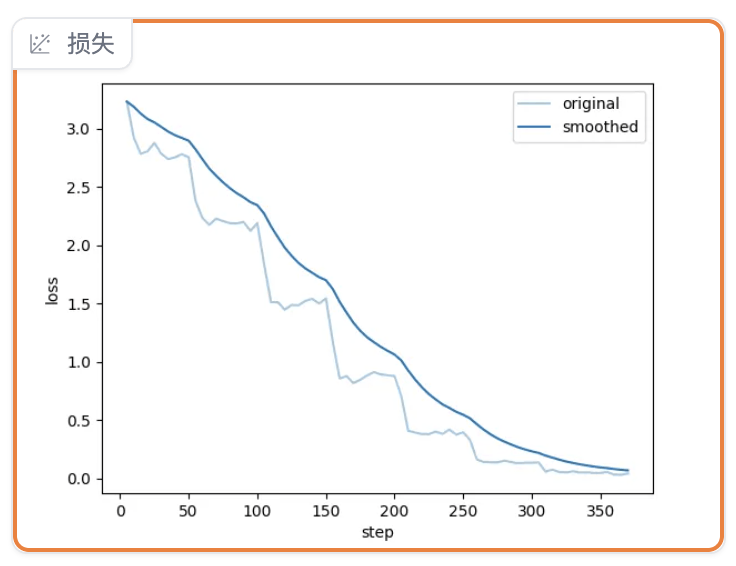
在 llama factory 右下角可以看到 损失率 的图,一般降到 0.5 就可以了。
如果降不到 0.5,有 3 个办法。
- 增大数据集
- 增大学习率
- 增大训练轮数
5 推理测试